W ujawnionym dokumencie prezydencja irlandzka proponuje państwom członkowskim UE, aby dążenie firm OpenAI, Anthropic, Google, Meta i SpaceX do osiągania zysków miało pierwszeństwo przed podstawowym prawem do ochrony danych. Wykorzystanie danych osobowych „w kontekście sztucznej inteligencji” powinno automatycznie być zgodne z prawem. Wydaje się, że istnieje szerokie nieformalne porozumienie między wieloma państwami członkowskimi. W szczególności wielkie firmy technologiczne mogłyby wykorzystywać wszystkie dane osobowe zgromadzone w ciągu ostatnich dziesięcioleci praktycznie bez żadnych ograniczeń, o ile odbywałoby się to „w kontekście” sztucznej inteligencji. Schrems: „Zgodnie z tymi propozycjami zyski firm zajmujących się sztuczną inteligencją przeważyłyby nad podstawowym prawem Europejczyków do prywatności. To nic innego jak cyfrowa wywłaszczenie Europejczyków”. Wszystko to dzieje się pomimo tego, że kluczowe postaci z korporacji zajmujących się sztuczną inteligencją aktywnie ostrzegają przed ogromnym ryzykiem związanym z ich własnymi produktami.
- Artykuł serwisu Politico zawierający dokumenty, które początkowo wyciekły do sieci (dostęp płatny)
- Wyciekła radykalna propozycja prezydencji irlandzkiej (PDF)
- Propozycja Niemiec dotycząca znaczącej liberalizacji działalności przedsiębiorstw zajmujących się sztuczną inteligencją (PDF)
- Strona przeglądowa Komisji Europejskiej poświęcona „pakietowi cyfrowemu”
Ostatnie bariery upadają: czy zyski firm zajmujących się sztuczną inteligencją przeważają nad ochroną danych? Wramach wniosku dotyczącego pakietu „Digital Omnibus” Komisja Europejska twierdziła, że wprowadza jedynie niewielkie uproszczenia dla przedsiębiorstw z UE, jednocześnie wyraźnie deklarując utrzymanie „wysokiego poziomu ochrony” dla Europejczyków. Ponieważ zmiany miały być minimalne, wybrano „procedurę przyspieszoną” – bez oceny wpływu na prawa podstawowe i bez bezpośredniego udziału europejskiej grupy ekspertów ds. ochrony danych.
Artykuł 88c zaproponowany przez Komisję Europejską (obecnie art. 88bis w dokumencie Rady) ma na celu liberalizację wykorzystania danych osobowych na potrzeby sztucznej inteligencji. Wniosek znajduje się obecnie w Radzie, gdzie stery sprawuje prezydencja irlandzka. Irlandia pełni rolę siedziby w UE dla większości amerykańskich i chińskich korporacji zajmujących się sztuczną inteligencją, od SpaceX po TikTok.
Przy wsparciu Niemiec i innych potęg UE proponuje się obecnie, aby w przypadku wykorzystywania danych osobowych „w kontekście sztucznej inteligencji”, przedsiębiorstwa miały zasadniczo prawo robić praktycznie wszystko. Interesy komercyjne firm zajmujących się sztuczną inteligencją powinny zasadniczo przeważać nad podstawowymi prawami użytkowników. To ogólne zezwolenie miałoby również zastosowanie do osób, które nigdy nie były klientami danej firmy zajmującej się sztuczną inteligencją, oraz do danych wprowadzonych dziesiątki lat temu, na przykład w czatach lub w mediach społecznościowych. Przepis ten obejmowałby wszystkie dane osobowe, do których firma zajmująca się sztuczną inteligencją mogłaby w jakikolwiek sposób uzyskać dostęp. Nie ma potrzeby uzyskiwania zgody od użytkowników – automatycznie zakłada się, że firmy mają nadrzędny „uzasadniony interes”, jeśli szkolą modele lub wykorzystują jakikolwiek produkt oparty na sztucznej inteligencji.
Schrems: „Prawdopodobnie większość państw członkowskich UE twierdzi obecnie, że interesy Elona Muska, Zuckerberga, Google’a czy OpenAI, polegające na osiąganiu ogromnych zysków, powinny mieć pierwszeństwo przed podstawowym prawem Europejczyków do ochrony danych. Jest to nic innego jak »cyfrowe wywłaszczenie« Europejczyków. Wszystko, co kiedykolwiek wprowadziliśmy do systemów cyfrowych lub co korporacje zajmujące się sztuczną inteligencją uzyskały w inny sposób, staje się dla nich łakomym kąskiem do wykorzystania”
Sprzedaż europejskich danych do Stanów Zjednoczonych i Chin. Politycy wydają się wierzyć, że europejska gospodarka skorzysta na zniesieniu jak największej liczby przepisów. Niemniej jednak można spodziewać się czegoś zupełnie przeciwnego: większość przedsiębiorstw z UE nie ma ani dostępu do takiej samej ilości danych, ani kapitału, by konkurować z korporacjami amerykańskimi. W wielu przypadkach może to również oznaczać, że dane gromadzone przez przedsiębiorstwa z UE (ale przetwarzane na platformach lub w ramach usług w USA) trafiałyby do dostawców w USA lub Chinach.
Schrems: „Ta zmiana legislacyjna przynosi korzyści przede wszystkim wielkim graczom, tym, którzy zgromadzili ogromne ilości danych Europejczyków. To całkowita wyprzedaż europejskich danych na rzecz globalnych korporacji. Spowodowałoby to również przepływ znacznej ilości know-how z przedsiębiorstw unijnych do Stanów Zjednoczonych lub Chin. Z punktu widzenia polityki przemysłowej takie podejście jest szaleństwem”.
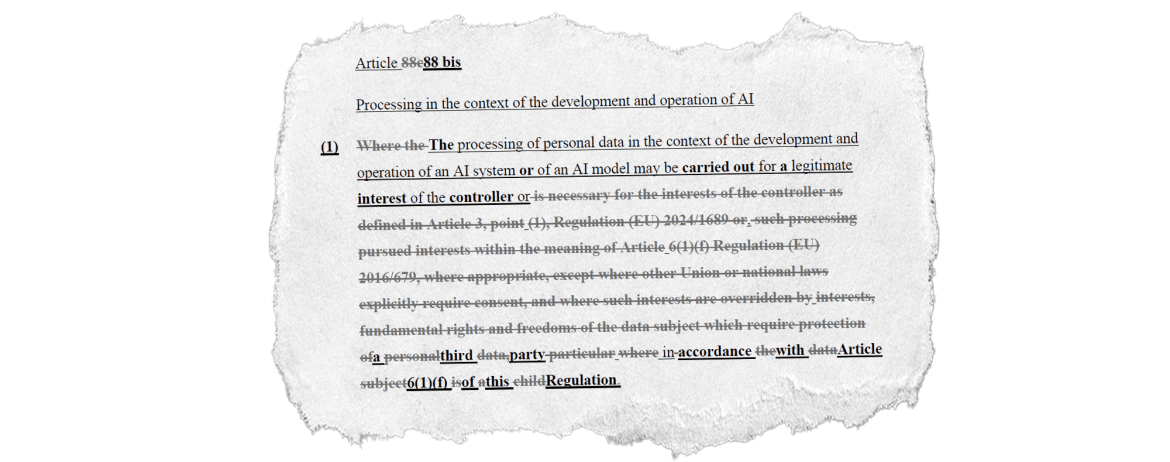
Czyste konto dla całej technologii? ZazwyczajRODO zezwala na przetwarzanie danych w konkretnych celach (np. przechowywanie danych dla celów podatkowych lub zapobieganie oszustwom). Jednak proponowany obecnie art. 88c (lub art. 88bis) legitymizuje całą technologię. Niezależnie od celu, w jakim jest wykorzystywany, każdy system sztucznej inteligencji domyślnie i zgodnie z prawem gromadziłby wszelkie dane osobowe. Na przykład proponowany artykuł zezwalałby również na szkolenie i wykorzystywanie sztucznej inteligencji do manipulacji, dezinformacji, generowania obrazów przedstawiających nagość, a także dronów bojowych i faktycznie każdego innego wątpliwego celu. Wiele operacji przetwarzania danych, które dotychczas były nielegalne, nagle stałoby się legalne – tylko dlatego, że są one przeprowadzane „w kontekście” systemu sztucznej inteligencji. Na przykład przetwarzanie danych do celów reklamy spersonalizowanej (bez zgody) jest obecnie nielegalne w UE. Teraz jednak, jeśli reklama ma być spersonalizowana przy użyciu technologii sztucznej inteligencji, nagle stałaby się legalna.
Schrems: „To tak, jakby powiedzieć, że wszystko jest dozwolone – bez względu na to, co się robi – o ile tylko odbywa się to przy użyciu konkretnej technologii. Wiele działań, które wcześniej były nielegalne, nagle stałoby się legalne, o ile tylko wykorzystuje się sztuczną inteligencję. To całkowicie absurdalne, aby traktować technologię wysokiego ryzyka w sposób preferencyjny w stosunku do wszystkich innych systemów komputerowych”.
Trwająca od 45 lat obietnica ochrony danych legła w gruzach. Na poziomie europejskim przepisydotyczące ochrony danych istnieją od 1981 roku. Od dziesięcioleci Europejczykom obiecuje się, że taka (rzekomo) „ścisła” ochrona danych zapewni, że platformy takie jak Twitter/X, Facebook czy Instagram oraz korporacje takie jak Google czy Microsoft, które gromadzą ogromne ilości danych, „nigdy” nie wykorzystają ich do celów innych niż te, dla których zostały udostępnione. Proponowany artykuł 88c (obecnie 88bis) łamie tę obietnicę: wszystkie zebrane dane stają się nagle dostępne do dowolnego wykorzystania przez dowolny system sztucznej inteligencji.
Schrems: „Od lat 80. obiecujemy ludziom, że choć duże korporacje mogą przechowywać dane, to mogą je wykorzystywać jedynie w ograniczonym zakresie. Artykuł 88bis nagle otwiera szeroko bramy i zezwala na nieograniczone wykorzystanie wszystkich danych na potrzeby sztucznej inteligencji.”
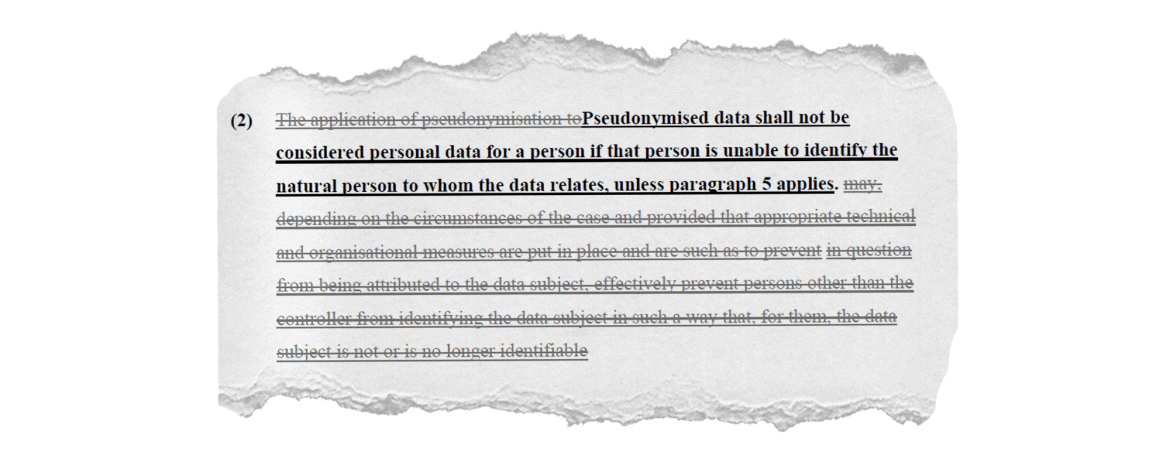
Kolejne rażące propozycje: Państwa członkowskie UE zaproponowały ponadto drastyczne zawężenie definicji „danych osobowych”, co oznacza między innymi, że nie jest jasne, czy na przykład śledzenie aktywności w sieci nadal będzie objęte zakresem RODO. Co więcej, prawa osób, których dane dotyczą, nie powinny mieć zastosowania, jeśli są one „nadużywane” przez te osoby. W praktyce decyzja o tym, czy dane nadal mają charakter „osobowy”, czy też korzystanie z prawa jest „nadużyciem”, należałaby przede wszystkim do przedsiębiorstw. Oba te środki sprawiłyby, że egzekwowanie RODO w praktyce stałoby się niemal niemożliwe. Jeszcze zanim ustalono by, czy RODO ma zastosowanie, pojawiłyby się już debaty dotyczące możliwości i intencji przedsiębiorstw oraz osób, których dane dotyczą. W praktyce może to trwać lata i kosztować dziesiątki tysięcy euro.
Schrems: „Te zmiany są żywcem zaczerpnięte z podręcznika każdej dużej kancelarii prawnej broniącej gigantów technologicznych. Spędzamy lata w sądach i przed organami administracyjnymi, aby doprowadzić do odrzucenia tych roszczeń. Prawodawca unijny prawdopodobnie jeszcze je wzmocni, a tym samym sprawi, że prawo UE stanie się jeszcze bardziej skomplikowane i niemożliwe do egzekwowania.”
Stanowisko Komisji Europejskiej i Parlamentu Europejskiego. Komisja Europejska jakiś czas temu dokonała zwrotu o 180 stopni i obecnie wyraźnie przedkłada interesy lobby przemysłowego nad prawa podstawowe. Stanowisko Parlamentu Europejskiego pozostaje niejednoznaczne. Podczas gdy większość członków Europejskiej Partii Ludowej opowiada się za wprowadzaniem coraz większej liczby luk w unijnych przepisach dotyczących gospodarki cyfrowej, posłowie do Parlamentu Europejskiego z frakcji centrolewicowych jak dotąd sprzeciwiają się tym pomysłom. Coraz częściej również ugrupowania skrajnie prawicowe sprzeciwiają się propozycjom przyznania „wolnej ręki” wielkim firmom technologicznym.
Ostatnia nadzieja: Trybunał Sprawiedliwości?Głównympytaniemwydaje się byćto, czy prawo pozbawione jakichkolwiek znaczących ograniczeń da się w ogóle pogodzić z prawami podstawowymi UE. W przeszłości Europejski Trybunał Sprawiedliwości unieważniał przepisy unijne w sprawach dotyczących znacznie mniej poważnych naruszeń praw podstawowych UE, takich jak zatrzymywanie danych czy przekazywanie danych z UE do Stanów Zjednoczonych.
Schrems: „Jeśli prawodawca stracił wszelkie poczucie proporcji i orientację, obywatele mogą zwrócić się jedynie do sądów. Każda skrajna ustawa, która wiąże się z wysokim ryzykiem unieważnienia, spowodowałaby jednocześnie jedynie większą niepewność prawną – zamiast obiecanego uproszczenia.”